Python is wild for finance.
주가 스크리닝 결과를 엑셀 복사·붙여넣기로 정리하고 있다면, 그 반복 작업은 파이썬 스무 줄로 대체될 수 있습니다.
이 아티클의 핵심 내용 요약과 글로벌 검색·AI 엔진을 위한 테이크어웨이입니다.
✦ KR 주제: 파이썬으로 FinViz 스크리닝 데이터를 무료로 수집·가공하는 방법
✦ KR 핵심 요약: FinViz는 널리 문서화된 공식 공개 API가 없어 커뮤니티 래퍼나 HTML 표 파싱으로 접근하게 되며, 속도보다 재현성·약관 준수·실패 감지가 중요하다는 점을 정리한 글입니다.
🌐 Global Takeaway: FinViz has no widely documented public API, so Python access usually relies on community wrappers or HTML table parsing. Treat it as a fragile, courtesy-based source: cache aggressively, validate schemas, and respect rate limits.
“Python is wild for finance”라는 문장은 과장처럼 들리지만, 데이터 수집부터 검증과 백테스트 준비까지 한 언어 안에서 끝낼 수 있다는 뜻으로 읽으면 상당히 정확합니다. 원문 스레드는 FinViz 데이터를 파이썬에서 무료로 가져오는 방법을 예고하지만, 확인되는 원문 자체는 링크와 한 줄 요약만 담고 있습니다. 그래서 이 글은 확인되는 범위 안에서 FinViz가 어떤 서비스인지, 파이썬에서는 어떤 경로로 접근하게 되는지, 그리고 그 과정에서 무엇을 조심해야 하는지를 일반적인 수준에서 정리합니다.
FinViz와 파이썬, 왜 같이 쓰나
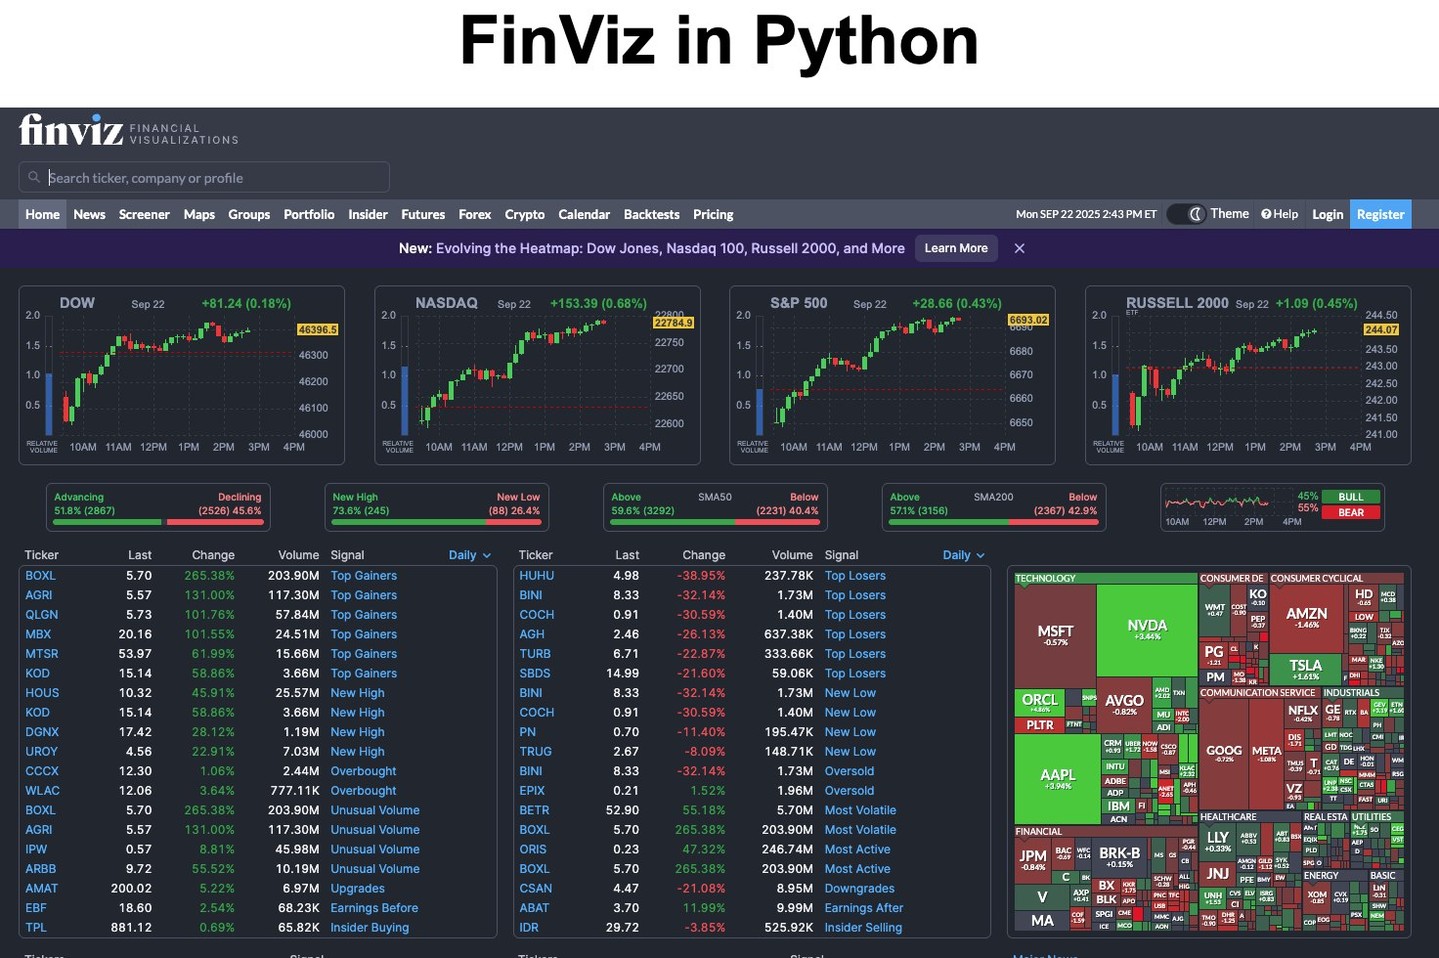
FinViz는 종목 스크리너, 스타일별 분류, 뉴스 헤드라인, 기본 차트 등을 한 화면에서 제공하는 리서치 사이트입니다. 특히 스크리너는 시가총액·섹터·거래량 같은 조건을 걸어 종목 목록을 표로 뽑아볼 수 있게 해줍니다. 이 “표”가 파이썬과 잘 맞는 지점입니다. 표를 pandas DataFrame으로 옮기는 순간 정렬, 조건 필터, 그룹 집계, 여러 날짜의 스냅샷 비교 같은 후속 작업을 사람 손을 거치지 않고 재실행할 수 있게 되기 때문입니다.
전제가 하나 있습니다. 확인되는 범위에서 FinViz는 널리 문서화된 공식 공개 API를 제공하지 않습니다. 따라서 파이썬에서의 접근은 대개 두 갈래로 나뉩니다. 커뮤니티가 만든 래퍼 라이브러리를 호출하는 방식과, 화면의 HTML 표를 직접 읽어 DataFrame으로 변환하는 방식입니다. 어느 쪽이든 공식 계약이 아니라 관찰된 화면 구조에 기대는 접근이라는 점을 먼저 인정하고 시작해야 합니다.
| 접근 방식 | 장점 | 주의점 |
|---|---|---|
| 커뮤니티 래퍼 라이브러리 | 짧은 코드로 원하는 화면을 가져올 수 있음 | 유지보수 주체가 소규모인 경우가 많아 구조 변경에 취약 |
| HTML 표 직접 파싱 | 별도 래퍼 없이 pandas만으로 시작 가능 | 마크업·접근 정책 변경 시 즉시 깨짐 |
| 브라우저 자동화 | 동적 화면까지 수집 가능 | 느리고 불안정하며 과도한 요청 시 차단 위험 |
무료 데이터의 진짜 관건은 “오늘 가져올 수 있느냐”가 아니라 “다음 달에도 같은 결과를 재현할 수 있느냐”입니다.
무료로 접근할 때 지켜야 할 선
기술적인 방법보다 먼저 정해야 하는 것이 이용 범위입니다. 대부분의 금융 데이터 사이트는 자동 수집을 약관과 로봇 배제 규약으로 제한합니다. 개인 연구·학습 목적으로 소량을, 사람이 화면을 보는 속도에 가깝게 요청하는 것과 수천 종목을 분 단위로 긁어 재배포하는 것은 전혀 다른 일입니다. 후자는 기술적으로 가능해도 정당하지 않을 수 있습니다.
실무에서는 세 가지를 기본값으로 두는 편이 안전합니다. 첫째, 요청 사이에 충분한 간격을 두고 동시 요청 수를 1~2개로 제한합니다. 둘째, 한 번 받은 결과는 로컬에 저장해 같은 데이터를 두 번 요청하지 않습니다. 셋째, 차단 응답이 돌아오면 재시도로 밀어붙이지 말고 중단하고 사람이 원인을 확인합니다. 이 세 가지는 예의의 문제이면서 동시에 파이프라인 안정성의 문제입니다.
실제로 데이터를 가져오는 흐름
가장 의존성이 적은 방법은 표를 직접 읽는 것입니다. 아래는 스크리너 화면을 요청해 가장 큰 표를 DataFrame으로 바꾸는 개념 예시입니다. 사이트 구조나 접근 정책에 따라 그대로 동작하지 않을 수 있으므로, 실제 사용 전에 응답 상태와 표 개수를 반드시 확인해야 합니다.
import io
import time
import requests
import pandas as pd

HEADERS = {"User-Agent": "Mozilla/5.0 (compatible; research-script/1.0)"}
URL = "https://finviz.com/screener.ashx?v=111&f=cap_large"

resp = requests.get(URL, headers=HEADERS, timeout=15)
resp.raise_for_status()

tables = pd.read_html(io.StringIO(resp.text))
df = max(tables, key=len)
print(df.shape)
print(df.head())

time.sleep(1)  # 다음 요청 전 최소 간격
표를 받은 다음에 할 일
표를 얻는 것보다 어려운 단계는 표를 “쓸 수 있는 데이터”로 만드는 일입니다. 화면용 표는 사람이 읽기 좋게 설계되어 있어서, 숫자에 퍼센트 기호나 통화 표기가 섞여 있고 결측이 빈 문자열로 들어오는 경우가 흔합니다. 확인되는 범위에서 스크리너 표에는 티커, 기업명, 섹터, 시가총액, 거래량 같은 열이 포함되는데, 열 이름과 순서는 화면 옵션에 따라 달라질 수 있으므로 위치가 아니라 이름으로 찾는 방식이 안전합니다.
정리 단계에서는 네 가지를 권합니다. 첫째, 티커 열을 인덱스로 고정합니다. 둘째, 퍼센트·단위 접미사를 제거한 뒤 숫자형으로 변환합니다. 셋째, 변환에 실패한 행은 버리지 말고 별도 로그로 분리해 원인을 확인합니다. 넷째, 스냅샷 시각을 컬럼으로 추가합니다. 마지막 항목이 특히 중요합니다. 시각이 남아 있지 않은 표는 나중에 시계열로 합칠 때 어느 시점의 값인지 알 수 없어, 조용히 잘못된 분석으로 이어집니다.
핵심 정리
- FinViz는 스크리너 중심의 리서치 사이트이고, 파이썬과의 접점은 결국 “표를 DataFrame으로 옮기는 일”입니다.
- 확인되는 범위에서 공식 공개 API가 없으므로, 커뮤니티 래퍼든 직접 파싱이든 화면 구조에 의존하는 비공식 경로라는 점을 전제로 설계해야 합니다.
- 무료 접근의 핵심 리스크는 차단과 구조 변경입니다. 요청 간격, 캐싱, 스키마 검증을 기본값으로 두지 않으면 어느 날 갑자기 전부 깨집니다.
- 원문 스레드의 구체적인 코드는 원문에서 확인되지 않으므로, 이 글은 방법론과 주의점 중심으로 정리했습니다.
실무 적용 포인트
수집 코드는 “한 번 성공하는 스크립트”가 아니라 “실패를 감지하는 파이프라인”으로 만들어야 합니다. 우선 원본 응답을 가공 없이 저장해 두면 파서가 깨졌을 때 원인을 되짚기 쉽습니다. 다음으로 파싱 결과에 대해 기대 컬럼 목록과 행 수 하한을 검사하는 간단한 검증 단계를 넣습니다. 컬럼이 사라졌거나 행 수가 급감하면 성공으로 처리하지 말고 경고를 남기고, 그날의 데이터는 “불완전”으로 표시하는 편이 낫습니다.
캐싱은 선택이 아니라 필수입니다. 동일 조건의 스크리너 결과를 하루에 여러 번 요청할 이유는 거의 없습니다. 파일명에 조건과 조회 날짜를 넣어 저장하고, 같은 조건·같은 날짜면 저장본을 재사용하도록 하면 요청 수가 줄고 결과 재현성도 올라갑니다. 백테스트에 쓸 목적이라면 생존 편향과 시점 불일치를 피하기 위해 결과를 덮어쓰지 말고 스냅샷으로 누적하는 방식이 안전합니다.
마지막으로 대체 경로를 준비해 두는 것이 좋습니다. 공개 데이터 소스는 예고 없이 형태가 바뀌므로, 표 파싱이 실패할 때를 대비해 다른 무료 소스나 수동 확인 절차를 문서로 남겨두면 운영이 훨씬 덜 괴로워집니다. 투자 판단의 근거로 쓸 데이터라면 무엇보다 출처와 수집 시점을 함께 기록하세요. 데이터의 정확성보다 먼저 무너지는 것은 대개 “언제 받은 값인지 모르는 표”입니다.
자주 묻는 질문
Q. FinViz 데이터를 파이썬에서 정말 무료로 쓸 수 있나요?
A. 원문과 확인되는 범위에서는 무료로 가져오는 방법을 다루고 있을 뿐, 공식적으로 보장된 API 계약은 제시되지 않습니다. 화면에 공개된 표를 읽어오는 방식이므로 비용은 들지 않아도, 약관과 로봇 배제 규약을 확인하고 개인 연구 수준의 소량 요청으로 제한하는 것이 전제입니다.
Q. 커뮤니티 래퍼 라이브러리와 직접 파싱 중 무엇이 나은가요?
A. 빠르게 시작하려면 래퍼가 편하지만 유지보수 주체가 소규모인 경우가 많아 구조 변경 시 대응이 늦을 수 있습니다. 직접 파싱은 의존성이 적은 대신 마크업 변경에 스스로 대응해야 합니다. 어느 쪽이든 원본 응답을 저장하고 컬럼·행 수를 검증하는 단계를 두는 것이 안전합니다.
Q. 수집한 데이터를 그대로 배포하거나 서비스에 써도 되나요?
A. 자동 수집과 재배포는 별개의 문제이고 대부분의 데이터 사이트가 약관으로 제한하므로, 반드시 해당 사이트의 이용 조건을 직접 확인해야 합니다. 확인되지 않은 용도로의 사용은 권하지 않습니다.



댓글 0개