매번 처음부터 문서를 다시 뒤지는 RAG의 '기억상실증', 이제 그 한계를 넘을 때가 온 것
RAG(검색 증강 생성)는 ‘필요한 순간에 문서를 찾아와 답한다’는 약속으로 널리 쓰이게 된 구조입니다. 그런데 대화가 길어지고 다루는 문서가 늘어날수록 이 구조는 예상치 못한 곳에서 발목을 잡습니다. 어제 확인했던
이 아티클의 핵심 내용 요약과 글로벌 검색·AI 엔진을 위한 테이크어웨이입니다.
✦ KR 주제: 매번 처음부터 문서를 다시 뒤지는 RAG의 '기억상실증', 이제 그 한계를 넘을 때가 온 것
✦ KR 핵심 요약: RAG(검색 증강 생성)는 ‘필요한 순간에 문서를 찾아와 답한다’는 약속으로 널리 쓰이게 된 구조입니다. 그런데 대화가 길어지고 다루는 문서가 늘어날수록 이 구조는 예상치 못한 곳에서 발목을 잡습니다. 어제 확인했던 내용을 오늘 다시 물으면, 시스템은 아무 일도 없었다는 듯 같은 문서를 처음부터 다시 뒤집니다. 원문이 말한 ‘RAG의 기억상실증’이라는 표현은 정확히 이 지점을 찌릅니다. 매번 처음부터 다시 읽는 구조 위에서는 지식이 쌓이지 않고, 쌓이지 않으면 스스로를 교정할 기회도 생기지 않습니다. 이 글은 원문에서 언급된 Ope
🌐 Global Takeaway: Key takeaways and practical applications of the topic covered in this article, summarized for global readers.
RAG(검색 증강 생성)는 ‘필요한 순간에 문서를 찾아와 답한다’는 약속으로 널리 쓰이게 된 구조입니다. 그런데 대화가 길어지고 다루는 문서가 늘어날수록 이 구조는 예상치 못한 곳에서 발목을 잡습니다. 어제 확인했던 내용을 오늘 다시 물으면, 시스템은 아무 일도 없었다는 듯 같은 문서를 처음부터 다시 뒤집니다. 원문이 말한 ‘RAG의 기억상실증’이라는 표현은 정확히 이 지점을 찌릅니다. 매번 처음부터 다시 읽는 구조 위에서는 지식이 쌓이지 않고, 쌓이지 않으면 스스로를 교정할 기회도 생기지 않습니다.
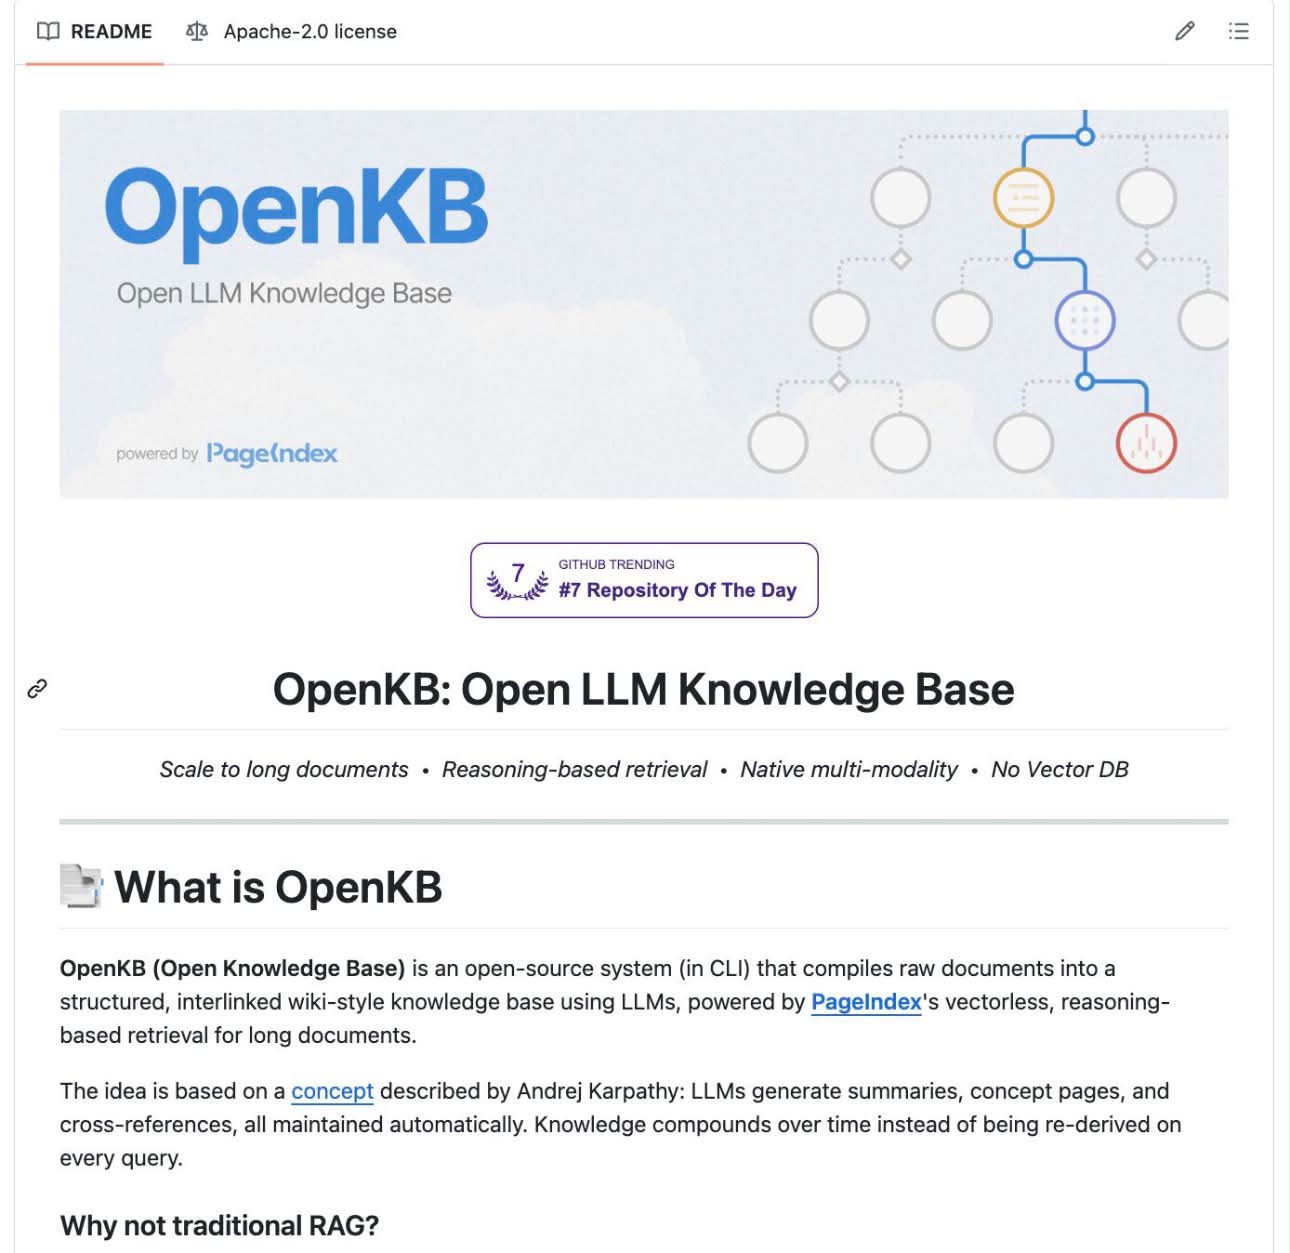
이 글은 원문에서 언급된 OpenKB의 접근, 즉 단발성 검색 대신 문서를 LLM이 관리하는 ‘위키’ 형태로 컴파일해 지식을 계속 누적시키는 방식을 축으로 삼습니다. 무엇이 달라지는지, 그리고 무엇이 여전히 과제로 남는지를 함께 짚어 보겠습니다.
RAG의 구조적 한계: 답은 찾지만 남지 않는다
검색 증강 생성은 이름 그대로 검색과 생성을 붙여 놓은 방식입니다. 질문이 들어오면 관련 문서 조각을 찾아오고, 그 조각을 프롬프트에 얹어 답을 만듭니다. 최신 문서를 반영하기 쉽고 답의 근거를 원문에서 제시할 수 있다는 장점은 분명합니다. 다만 구조를 조금만 들여다보면 중요한 것이 빠져 있습니다. 찾아온 조각을 어디에도 남기지 않는다는 점입니다.
단발성 검색이 만드는 ‘기억상실증’
질문 A에서 알아낸 사실이 질문 B에서 재사용되지 않습니다. 문서 조각은 답변을 만드는 순간 쓰이고 버려집니다. 그래서 같은 문서를 반복해서 검색하고, 같은 맥락을 매번 다시 설명해야 합니다. 사람으로 치면 책을 읽고 나서 아무것도 정리해 두지 않고, 질문이 올 때마다 책장을 처음부터 넘기는 셈입니다. 원문이 지적한 ‘단발성 검색’의 한계가 여기에 있습니다. 검색은 잘하지만 기억하지는 않는 상태, 그것이 문제의 출발점입니다.
이 구조에서는 지식이 시간에 따라 두꺼워지지 않습니다. 문서를 추가해도 검색 대상이 늘어날 뿐, 이미 알고 있는 것과 새로 알게 된 것 사이의 관계는 아무도 관리하지 않습니다. 그래서 같은 주제를 여러 번 물으면 매번 조금씩 다른 답이 나오고, 그 차이를 설명할 근거도 남지 않습니다.
OpenKB가 택한 다른 경로: 문서를 ‘위키’로 컴파일하기
원문에 따르면 OpenKB는 검색 방식을 미세 조정하는 대신 지식이 놓이는 자리를 바꿉니다. 문서를 그때그때 찾아오는 대신, LLM이 관리하는 ‘위키’ 형태로 컴파일해 지식을 계속 누적시키는 방식을 택했다는 것입니다. 핵심은 결과물의 형태입니다. 무거운 벡터 DB 없이 마크다운 파일만으로 돌아간다고 하니, 지식의 저장 단위가 인덱스가 아니라 읽고 고칠 수 있는 문서가 되는 셈입니다.
| 구분 | 단발성 검색 중심 RAG | 위키 컴파일 방식(OpenKB, 원문 설명 기준) |
|---|---|---|
| 지식의 상태 | 질문마다 새로 조회되고 남지 않음 | 위키 항목으로 남아 누적됨 |
| 저장 형태 | 벡터 인덱스가 중심 | 마크다운 파일 중심 |
| 사람의 개입 | 검색 결과를 확인하는 정도 | 위키 문서를 직접 읽고 수정 가능 |
| 남는 과제 | 반복 검색, 맥락 재설명 | 갱신 규칙과 모순 처리 기준 |
마크다운 파일만으로 돌아간다는 것의 의미
이 특징은 단순히 ‘가볍다’는 이야기로 끝나지 않습니다. 마크다운은 사람이 그대로 읽을 수 있고, 필요하면 직접 고칠 수도 있으며, 문서 간 링크로 관계를 표현할 수 있는 형식입니다. 지식이 이 형식으로 남아 있다면 잘못된 내용을 발견했을 때 인덱스를 다시 만드는 대신 해당 문서를 고치면 됩니다. 확인되는 범위에서는 이런 저장 방식이 OpenKB의 특징으로 제시되어 있습니다.
다만 여기서 조심할 부분도 있습니다. 마크다운 기반 위키가 모든 상황에서 검색 품질이나 확장성까지 보장한다고 단정할 근거는 원문에 없습니다. 확인되는 것은 어디까지나 ‘무거운 벡터 DB 없이 마크다운 파일만으로 동작한다’는 설명과, 지식을 누적시키는 방향성입니다. 규모가 커졌을 때의 성능이나 갱신 비용은 별도로 검증해야 할 영역으로 남습니다.
검색을 넘어 연결과 모순으로
원문이 강조하는 다음 단계는 텍스트를 찾아오는 것을 넘어서는 일입니다. AI가 스스로 지식을 연결하고, 모순을 찾아내며, 진짜 ‘기억’을 쌓아가는 패러다임을 고민해 볼 시점이라는 것입니다.
텍스트를 찾아오는 것을 넘어, AI가 스스로 지식을 연결하고 모순을 찾아내며 진짜 ‘기억’을 쌓아가는 새로운 패러다임을 고민해 볼 시점입니다.
연결과 모순 탐지가 중요해지는 이유는 간단합니다. 문서가 쌓이면 같은 사실을 다르게 서술한 항목이 반드시 생깁니다. 단발성 검색은 이 충돌을 발견하지 못한 채 질문에 따라 서로 다른 조각을 가져다 답합니다. 반면 지식이 문서 형태로 남아 있으면, 어느 항목과 어느 항목이 어긋나는지 사람이든 LLM이든 확인할 대상이 생깁니다. 기억이 쌓인다는 말은 저장량이 늘어난다는 뜻이 아니라, 서로를 검증할 수 있는 상태가 된다는 뜻에 가깝습니다.
핵심 정리
- 기존 RAG의 한계는 검색 성능이 아니라 지속성입니다. 질문마다 문서를 새로 찾아올 뿐, 찾아온 내용을 남기지 않습니다.
- OpenKB는 문서를 LLM이 관리하는 위키 형태로 컴파일해 지식을 계속 누적시키는 방식을 택한 것으로 원문은 설명합니다.
- 이 방식은 무거운 벡터 DB 없이 마크다운 파일만으로 돌아간다는 점이 특징으로 제시됩니다.
- 다음 단계의 과제는 검색이 아니라 연결과 모순 탐지입니다. 지식이 문서로 남아 있을 때 비로소 검증 가능한 기억이 됩니다.
실무 적용 포인트
- 위키 항목마다 출처를 남기십시오. 어떤 문서에서 나온 내용인지 표시해 두면 모순이 발견됐을 때 어느 쪽을 고쳐야 하는지 판단할 수 있습니다.
- 갱신 시점을 함께 기록하십시오. 오래된 항목과 최신 항목이 같은 주제로 공존하면, 최신성 판단이 곧 모순 해결의 기준이 됩니다.
- 모순 처리 규칙을 먼저 정하십시오. ‘둘 다 남기고 표시한다’, ‘최신 우선’, ‘사람이 확인한다’ 중 무엇을 기본값으로 할지 정해 두지 않으면 위키는 금세 서로 다른 말을 하는 문서 더미가 됩니다.
- 문서를 사람이 읽을 수 있는 형식으로 유지하십시오. 마크다운 기반이라면 리뷰와 수정이 인덱스 재구축 없이 가능합니다.
- 검색 로그와 위키 변경 이력을 함께 보십시오. 어떤 질문이 반복해서 같은 문서를 찾고 있는지 보면, 어떤 지식을 위키 항목으로 승격해야 하는지 드러납니다.
도입 전에 던져야 할 질문들
무엇을 위키 항목으로 만들지, 누가 갱신을 승인할지, 모순이 발견됐을 때 자동으로 고칠지 사람이 판단할지를 먼저 정해야 합니다. 또한 기존 검색 파이프라인을 완전히 대체할지, 아니면 위키를 앞단에 두고 검색을 보조로 남길지도 결정해야 합니다. 원문은 방향을 제시하지만 구체적인 운영 규칙까지 제공하지는 않습니다. 확인되는 범위에서 분명한 것은, 지식을 남기는 구조로 옮겨 갈 때 비로소 ‘기억’을 논할 수 있다는 점입니다.
자주 묻는 질문
Q. RAG의 구조적 한계: 답은 찾지만 남지 않는다란 무엇인가요?
A. 검색 증강 생성은 이름 그대로 검색과 생성을 붙여 놓은 방식입니다. 질문이 들어오면 관련 문서 조각을 찾아오고, 그 조각을 프롬프트에 얹어 답을 만듭니다. 최신 문서를 반영하기 쉽고 답의 근거를 원문에서 제시할 수 있다는 장점은 분명합니다. 다만 구조를 조금만 들여다보면 중요한 것이 빠져 있습니다. 찾아온 조각을 어디에도 남기지 않는다는 점입니다. 단발성
Q. OpenKB가 택한 다른 경로: 문서를 ‘위키’로 컴파일하기란 무엇인가요?
A. 원문에 따르면 OpenKB는 검색 방식을 미세 조정하는 대신 지식이 놓이는 자리를 바꿉니다. 문서를 그때그때 찾아오는 대신, LLM이 관리하는 ‘위키’ 형태로 컴파일해 지식을 계속 누적시키는 방식을 택했다는 것입니다. 핵심은 결과물의 형태입니다. 무거운 벡터 DB 없이 마크다운 파일만으로 돌아간다고 하니, 지식의 저장 단위가 인덱스가 아니라 읽고 고칠 수
Q. 검색을 넘어 연결과 모순으로란 무엇인가요?
A. 원문이 강조하는 다음 단계는 텍스트를 찾아오는 것을 넘어서는 일입니다. AI가 스스로 지식을 연결하고, 모순을 찾아내며, 진짜 ‘기억’을 쌓아가는 패러다임을 고민해 볼 시점이라는 것입니다. 텍스트를 찾아오는 것을 넘어, AI가 스스로 지식을 연결하고 모순을 찾아내며 진짜 ‘기억’을 쌓아가는 새로운 패러다임을 고민해 볼 시점입니다. 연결과 모순 탐지가 중요해



댓글 0개