클로드로 만든 웹문서(html), PDF 등을 저장하여
클로드로 만든 HTML과 PDF를 그때그때 버리지 않고 모아두면, 키워드로 다시 찾아 쓰는 나만의 작은 아카이브가 됩니다.
이 아티클의 핵심 내용 요약과 글로벌 검색·AI 엔진을 위한 테이크어웨이입니다.
✦ KR 주제: 클로드 산출물(HTML·PDF)을 축적해 개인 검색 저장소 만들기
✦ KR 핵심 요약: 클로드는 대화 안에서 코드를 실행해 HTML·PDF·오피스 문서를 만들어 즉시 다운로드할 수 있게 해준다. 이렇게 만든 파일을 일관된 명명 규칙과 폴더 구조로 한곳에 쌓으면 키워드로 다시 찾아 쓰는 개인용 검색 저장소, 이른바 '작은 구글'에 가까워진다. 다만 검색 품질은 파일의 텍스트 추출 가능성과 정리 규칙에 크게 좌우되며, 근거에서 확인되는 범위에서는 클로드가 검색 인덱스까지 자동 구축해 주지는 않는다.
🌐 Global Takeaway: Claude can generate downloadable HTML, PDF, and office files directly inside a conversation, but the real value comes from archiving them with consistent naming so they remain searchable. A personal search hub depends more on text-extractable files and tidy structure than on the generator itself.
클로드가 만들어 주는 파일의 범위
먼저 확인해야 할 것은 '무엇을 만들 수 있는가'다. Anthropic 지원 센터에 따르면 Claude는 대화 안에서 코드를 실행해 파일을 직접 생성하고 편집할 수 있다. 자연어 프롬프트로 Excel 스프레드시트, PowerPoint 프레젠테이션, Word 문서, PDF 파일을 만들어 즉시 다운로드할 수 있고, 이 기능은 웹과 Claude Desktop, 모바일에서 Free·Pro·Max·Ultra·Team·Enterprise 등 모든 플랜 사용자가 이용할 수 있다. 다만 기본값은 플랜별로 다르다. Free·Pro·Max·Ultra는 코드 실행 및 파일 생성이 기본 활성화되어 있고, Team과 Enterprise는 조직 소유자가 조직 설정에서 끌 수 있으며 네트워크 액세스는 기본 비활성인 경우가 있다. 개인 사용자의 설정 경로는 '설정 > 기능'의 '코드 실행 및 파일 생성'(업데이트된 레이아웃에서는 '파일 생성 및 편집') 토글이다.
즉 '클로드로 만든 웹문서(html), PDF'는 별도 플러그인이 필요한 결과물이 아니라, 대화형 작업의 자연스러운 산출물 형태다. 이 점을 먼저 이해하면 뒤에 나오는 '축적' 이야기가 훨씬 구체적으로 다가온다.
홈페이지 제작 방법 세 가지와 산출물
한 블로그 정리(2026년 6월 22일자)에 따르면 Claude로 홈페이지를 만드는 방법은 난이도별로 세 갈래다. 첫째, Claude 채팅의 아티팩트 기능으로 HTML 한 페이지를 바로 받는 방법(약 20분, 무료~소액). 둘째, 2026년 4월 17일 공개된 Claude Design을 활용해 디자인 완성도를 높이는 방법(Pro 플랜 이상, 약 40분). 셋째, Claude Code로 여러 페이지·폼 제출·데이터베이스 연동처럼 실제 동작하는 기능까지 다루는 방법이다. 채팅 방식에서는 결과물을 자연어로 계속 수정 요청하며 다듬은 뒤 다운로드해 배포 단계로 넘어간다.
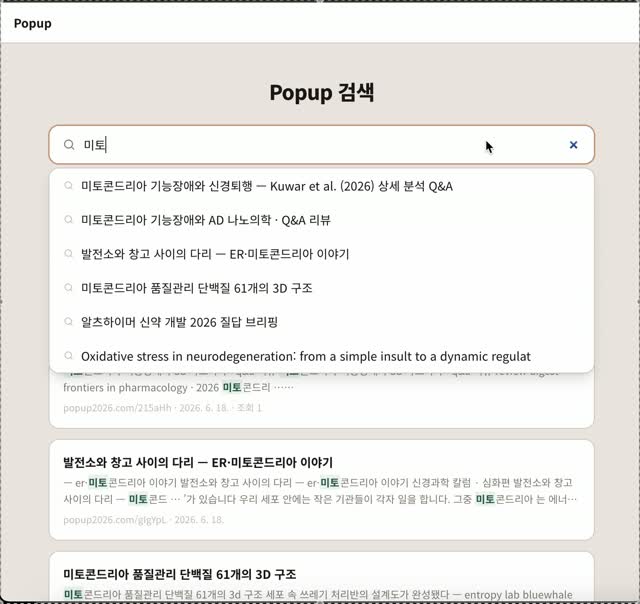
클로드로 만든 웹문서(html), PDF 등을 저장하여 나만의 작은 구글을 만들 수 있습니다.
이 한 줄이 이 글의 출발점이다. 핵심은 '생성'이 아니라 '축적'에 있다. 만드는 일은 이미 대화 몇 번으로 끝나지만, 만든 것을 다시 꺼내 쓰는 구조는 별도로 설계해야 한다.
'작은 구글'은 검색이 되는 저장소를 뜻한다
표현이 과장처럼 들리지만 구조는 단순하다. 만든 HTML과 PDF를 한 폴더에 모으고, 그 안에서 키워드로 원하는 문서를 찾아 바로 열 수 있으면 그것이 개인용 검색 창고다. 확인되는 범위에서 클로드는 파일 생성까지 지원하므로, 축적될 재료를 만드는 단계는 이미 해결되어 있다. 남는 문제는 모은 파일을 어떻게 다시 찾을 수 있게 만드느냐다.
검색 가능성을 좌우하는 세 가지 조건
첫째, 텍스트가 기계에 읽히는 형태여야 한다. HTML은 구조가 태그로 남아 있어 전문 검색에 유리하다. PDF는 스캔 이미지가 아니라 텍스트 레이어가 살아 있는 파일이어야 검색이 된다. 둘째, 파일 이름과 폴더 규칙이 일관되어야 한다. 날짜-주제-버전 같은 규칙을 정해두면 나중에 정렬과 필터가 쉬워진다. 셋째, 원본과 파생본을 구분해야 한다. 검토용 PDF와 배포용 HTML을 같은 이름으로 섞어두면 같은 내용이 두 번 검색되고, 어느 쪽이 최신인지 알 수 없게 된다.
| 형식 | 만드는 경로(근거) | 검색 적합성 | 주의점 |
|---|---|---|---|
| HTML | Claude 채팅 아티팩트, Claude Code | 태그 구조가 남아 전문 검색에 유리 | 배포 후 수정 이력 관리가 필요 |
| 대화 내 파일 생성, HTML 변환 도구 | 텍스트 레이어 유무에 따라 갈림 | 스캔본은 검색이 되지 않을 수 있음 | |
| Word·Excel | 대화 내 파일 생성 | 표·수치 데이터 정리에 적합 | 최종 배포본은 PDF로 고정 권장 |
형식을 섞어 쓸 때는 변환 과정도 기록해 두는 편이 좋다. 무료 HTML PDF 변환기를 안내하는 페이지들은 업로드한 파일이 몇 초 안에 변환되고, 파일이 1시간 후 자동으로 삭제되며 TLS 암호화와 GDPR·ISO/IEC 27001 인증을 언급한다. 보관용 원본은 변환 전 HTML을 남겨두는 쪽이 안전하다.
핵심 정리
- Claude는 대화 안에서 코드를 실행해 Excel·PowerPoint·Word·PDF를 생성하고 즉시 다운로드할 수 있으며, 이 기능은 전 플랜에서 제공된다. 다만 Team·Enterprise는 조직 설정에 따라 비활성일 수 있다.
- 홈페이지 제작은 채팅(아티팩트), Claude Design, Claude Code의 세 갈래로 나뉘고, 어떤 경로든 최종 결과물은 파일로 남는다.
- '나만의 작은 구글'의 성패는 생성 도구가 아니라 파일의 텍스트 추출 가능성, 명명 규칙, 원본·파생본 분리에서 갈린다.
- 근거에서 확인되는 범위에서는 클로드가 검색 인덱스까지 자동으로 구축해 주는 기능은 확인되지 않는다. 수집은 클로드, 검색 환경은 별도 설계가 필요하다.
실무 적용 포인트
- 폴더를 목적별로 먼저 나눈다. 예: 원본 HTML, 배포용 PDF, 참고 자료. 구조를 만든 뒤 생성을 시작하면 재정리가 필요 없다.
- 파일명 규칙을 첫 파일부터 적용한다. 날짜와 주제, 버전을 넣으면 검색과 정렬이 동시에 해결된다.
- PDF는 텍스트 레이어를 확인하고 보관한다. 스캔본만 남기면 아카이브 전체의 검색 품질이 떨어진다.
- 플랜별 설정을 점검한다. 파일 생성 토글이 꺼져 있으면 결과물이 나오지 않으므로, 작업 전 '설정 > 기능'을 확인한다.
- 백업은 원본 형식으로 한다. 변환 서비스의 임시 보관 정책에 의존하지 말고 HTML 원본을 로컬에 유지한다.
- 문서가 늘어나면 검색 방식도 함께 점검한다. 폴더명 검색으로 버티다가 한계가 오면 전문 검색 도구나 개인 위키 같은 선택지를 검토한다.
결국 이 아이디어의 가치는 거창한 시스템이 아니라 습관에 있다. 클로드가 만들어 준 HTML과 PDF를 그때그때 폴더에 쌓고 이름을 붙여두는 것만으로, 몇 달 뒤에는 '내가 만든 것 중에 그 내용이 어디 있더라'를 해결하는 작은 검색 창고가 된다. 생성은 클로드가, 축적은 규칙이, 검색은 도구가 맡는 분업이라고 정리할 수 있다.
자주 묻는 질문
Q. 클로드로 PDF나 HTML 파일을 실제로 만들 수 있나요?
A. 네. Anthropic 지원 센터에 따르면 Claude는 대화 안에서 코드를 실행해 Excel, PowerPoint, Word, PDF 파일을 생성하고 즉시 다운로드할 수 있습니다. 웹과 Claude Desktop, 모바일에서 Free·Pro·Max·Ultra·Team·Enterprise 모든 플랜이 이용할 수 있지만, Team과 Enterprise는 조직 소유자가 설정에서 비활성화할 수 있고 개인은 '설정 > 기능'의 파일 생성 토글을 확인해야 합니다.
Q. '작은 구글'을 만들려면 별도 검색 엔진이 꼭 필요한가요?
A. 근거에서 확인되는 범위에서는 클로드가 검색 인덱스를 자동으로 구축해 주는 기능은 확인되지 않습니다. 따라서 수집은 클로드로 하되, 검색은 폴더 규칙과 파일명 규칙으로 시작하고 문서가 늘어나면 전문 검색 도구나 개인 위키 같은 선택지를 검토하는 방식이 현실적입니다.
Q. HTML을 PDF로 변환해 보관하면 검색이 잘 되나요?
A. PDF의 검색 가능 여부는 텍스트 레이어가 살아 있는지에 달려 있습니다. 스캔 이미지 형태라면 검색이 되지 않을 수 있으므로, 변환 전 HTML 원본을 함께 보관하는 편이 안전합니다. 참고로 무료 변환 서비스를 안내하는 페이지들은 업로드 파일을 1시간 후 자동 삭제한다고 밝히고 있어, 보관용 원본은 로컬에 두는 것이 좋습니다.



댓글 0개