chandra — 스캔 읽는 OCR
← 목록으로 돌아가기
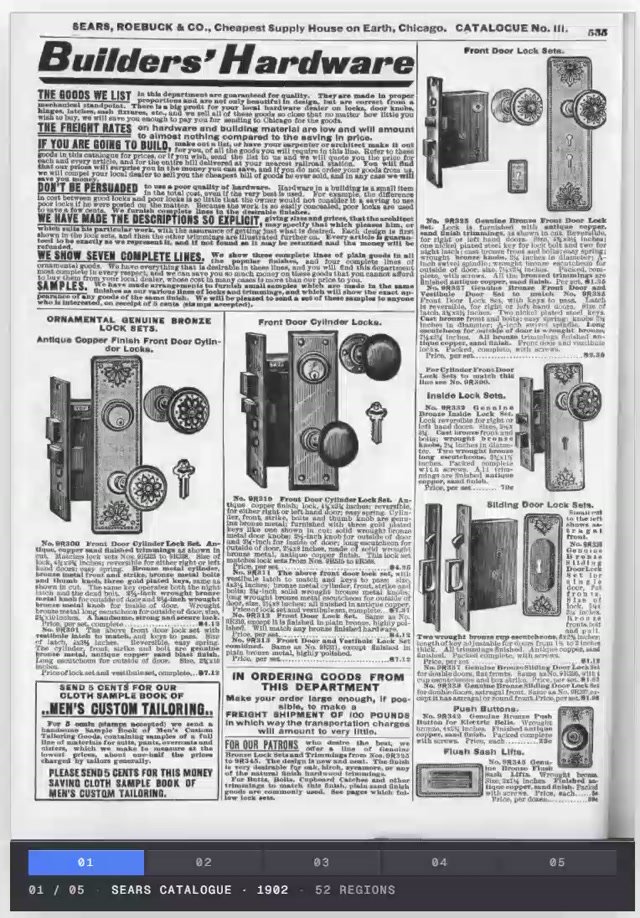
원본 스레드 첨부 이미지
안녕하세요. 야금야금입니다.
"문서 읽기 1개로 스타 1.2만" — chandra를 정리합니다.
📌 한눈에 보는 요약
✔️ chandra — 스캔 OCR 모델
✔️ 레이아웃·표·손글씨 구조 보존
✔️ 한 달 283만 다운로드
✔️ chandra — 스캔 OCR 모델
✔️ 레이아웃·표·손글씨 구조 보존
✔️ 한 달 283만 다운로드
STEP 0
해결하는 문제
그림 PDF
1스캔의 한계
텍스트가 아닌 그림
스캔으로 뽑은 PDF는 텍스트가 아닌 그림입니다 — 읽기 도구가 못 읽습니다. chandra는 이 빈칸을 채우는 OCR 모델로 한 달 283만 다운로드, 스타 1.2만을 받았습니다.
STEP 1
차이
읽는 구조가 다르다
2레이아웃 보존
텍스트만이 아니다
GPT·클로드도 이미지를 읽지만, chandra는 레이아웃을 살려 마크다운/HTML/JSON으로 냅니다 — 표·수식·복합 레이아웃, 양식의 체크박스, 손글씨, 이미지·도표 캡션까지 구조를 유지합니다. 90개 이상 언어를 지원하고 로컬에서 돌립니다.
283만월 다운로드
1.2만깃허브 별
90+지원 언어
스캔 PDF그림 문서→chandra레이아웃 인식→구조화 텍스트md·HTML·JSON
💡 개인에게 주는 시사점
문서 읽기는 "글자 인식"이 아니라 "구조 보존"이 답입니다 — 표와 양식을 그대로 살리는 OCR이 실무의 데이터를 만듭니다.
자주 묻는 질문
Q. 뭔가요?
A. 스캔 읽는 OCR 모델입니다.
Q. GPT와 다른 점은요?
A. 레이아웃 구조를 보존합니다.
Q. 얼마나 쓰이나요?
A. 월 283만 다운로드입니다.
마무리
오늘은 chandra를 정리했습니다.
스캔 문서가 있다면 돌려보세요.



댓글 0개